从零开始的完整讲解
Reconstruction 是一种学习任务,不是单一模型
重建任务要求从不完整或变换后的输入恢复某个目标。Autoencoder 可以从压缩表示重建原输入,denoising 模型从噪声输入恢复目标,masked image modeling 从可见部分预测隐藏部分。它们共享“预测被丢失的信息”的思路,但输入、目标和计算路径不同。
为什么这样能学表示?因为隐藏部分与可见部分存在结构关系:边缘会延续、物体形状有规律、场景中某些对象经常共现。模型若利用这些关系,可能获得对下游任务有用的特征;但重建成功本身并不证明学到了所有语义。
MAE 为什么只把可见块送进 encoder
原始 MAE 的一个关键设计是非对称结构:较重的 encoder 处理保留下来的可见 patch,较轻的 decoder 接收编码结果及 mask token,恢复完整位置顺序后预测像素。若一幅图有 196 个 patch、遮住 75%,encoder 只处理 49 个可见 patch,decoder 则恢复到全部位置。
这和“把遮住区域涂黑后仍把所有 token 送给完整 encoder”不一样。Mask token 不是黑色像素的 embedding,它代表待预测的位置。位置恢复顺序如果错了,输出 shape 依然正确,重建图却会错位。
Loss 必须说清楚在哪些像素上计算
设某个被遮住 patch 的真实像素向量为 y,预测为 y_hat,MSE 是每个分量平方误差的平均。MAE 通常对 masked patches 的重建计算目标。如果把大量可见区域也计入,而这些区域直接被复制,整体平均误差会被稀释。
举一个两像素例子:目标 [0,1],预测 [0.2,0.6],平方误差是 [0.04,0.16],MSE=0.10。它惩罚的是数值差,不直接评价“是否看起来像同一只猫”。归一化像素目标还需要记录均值和方差的处理,否则展示时可能把数值空间搞错。
为什么低 MSE 有时会产生模糊图像
若同一可见上下文允许多种合理隐藏内容,单一平方误差预测倾向于条件平均。几种可能纹理平均后会变得平滑。模糊不一定来自训练没有收敛,也可能是目标函数对不确定性的表达方式。
相反,低像素误差也不保证检索、分类或定位效果好。背景面积很大时,预测背景可能在数值上占优势。评估表示应另外做线性 probe、微调、检索或任务相关测试,而不是只挑好看的重建图。
一个诚实且可直接训练的浏览器基线
下方 Notebook 生成平滑灰度图,遮住 75% 像素,用可见像素训练 z=a*x+b*y+c。你可以直接观察参数更新与隐藏区域 MSE 下降。这是线性重建器,不是简化后仍可称为 MAE 的完整架构;它的作用是隔离“看见什么、拟合什么、在哪里评估”三件事。
随后把目标换成棋盘格,同一线性函数不能表达交替纹理,误差会上升。这个反例很重要:第一次成功依赖平滑图像的结构,不能据此声称模型理解任意图片。
真实 MAE 实验应该怎样阅读
完整 PyTorch Notebook 使用预训练 MAE 权重,展示原图、mask、预测及合成的可视结果。注意合成图中的可见区域可能直接来自原图,因此应单独查看 masked 区域质量。把随机 seed、mask ratio、预处理、目标归一化与 checkpoint 一起记录。
进一步研究时可以固定图片改变遮罩,再固定遮罩改变图片。前者检查信息缺失模式,后者检查内容分布。将这两个变量同时乱改,只能得到许多截图,难以解释差异来自哪里。
遮掉输入,制造监督
Masked autoencoding 隐藏一部分 patch,让模型利用可见区域预测缺失内容。原始图像提供目标,不需要人工为每张图标注类别。MAE 的重要结构选择是 encoder 只处理可见 patch,decoder 再加入 mask tokens 和位置信息来还原完整顺序。下游任务常复用 encoder,而非把重建 decoder 当识别头。
196 个 patch、75% mask 时,可见 49 个。注意 CLS 和实现细节可能让实际 encoder 序列长度多一个。Encoder 序列缩短并不等于整个模型计算严格减少 75%,因为 decoder、投影与其他操作仍存在。
Loss 只看哪些位置?
简化 masked MSE 为 ,这里每个 patch 的平方误差先按内部维度平均,m=1 代表隐藏。不要与 attention mask 的 1=有效位置惯例混淆。预测全部 patch 但只监督 masked patch,有助于避免模型只复制输入。
import torch
pred = torch.zeros(1, 4, 3)
target = torch.ones_like(pred)
mask = torch.tensor([[1.,0.,1.,0.]])
per_patch = ((pred-target)**2).mean(-1)
loss = (per_patch*mask).sum()/mask.sum()
assert loss.item() == 1.0
归一化 patch targets 会改变 loss 的尺度和重建显示方式。使用真实模型时读取 norm_pix_loss 等配置,不要直接把任意 logits 当作 0–255 像素。
重建漂亮不等于理解更好
像素目标会奖励纹理与低层细节;语义目标则可能希望忽略光照或背景。预测 latent representations 的方法改变监督空间,但要处理表示坍塌等问题。比较方法时分别测重建误差和迁移任务,不能用好看的补图证明检索或分类更强。
下方交互用合成灰度网格和常数预测器解释 masked loss,它没有训练过。真正的 facebook/vit-mae-base 重建在 Notebook:加载权重、固定随机 mask、显示原图/遮罩/重建,并打印模型自身 loss。
自测
问题: 把 mask ratio 设成 0,loss=0 是否说明模型完美?
展开答案
不说明。没有被监督的隐藏位置,分母为 0;实际训练应拒绝这种设置或显式定义空损失。本页计算器返回 0 只是展示约定。本次真实运行结果
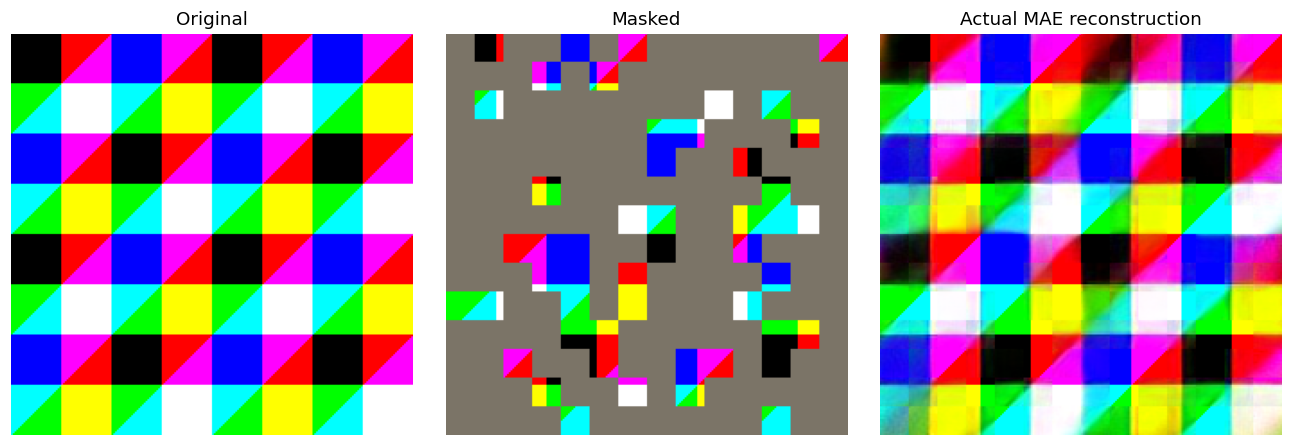
真实 vit-mae-base 在合成色块上的重建;不是手工补图,也不代表自然图像效果。
原始资料与继续阅读
资料核对:2026-09-10。教学示例不代表生产基准;框架 API 和模型支持请以所链接版本为准。
交互实验 · 实时数值计算
遮住 patch,只在隐藏位置计算损失
8×8 合成灰度网格。调整遮罩位置与常数预测,观察 masked MSE。这不是训练过的 MAE,真实权重重建在本路线 Notebook。
零遮罩时没有重建训练信号,显示 0 只是空集合约定,不能表示模型预测完美。