从零开始的完整讲解
Profiler 的第一任务是帮你提出可证伪的解释
“GPU 利用率不高,所以换更快的 GPU”不是诊断。设备可能在等数据、等另一张卡、等 CPU 发起操作,也可能被许多很小的 kernel 切碎。Profiler 将时间分解为可观察事件,让你判断哪个等待或计算真正处在关键路径上。
先明确慢的是哪件事:首 token、每 token、训练 step、数据加载还是 checkpoint 保存。一个工具截图无法同时回答所有问题,测量窗口必须对应你想改善的用户体验或训练阶段。
系统时间线与 kernel 指标是两种视角
Nsight Systems 适合先观察 CPU、GPU、传输和通信的相对时间关系;Nsight Compute 更聚焦具体 CUDA kernel 的执行特征。XProf 用于理解相应 TPU/加速器工作负载中的执行与性能线索。具体可用视图随运行环境而异。
正确顺序通常是先找耗时区域,再深入那个区域。如果一个 kernel 只占总时间的 1%,把它优化一倍也很难改变用户体验。相反,某个看起来不起眼的同步点可能让所有后续工作停住。
手算一次关键路径
假设一个 step 包含 20 ms 数据准备、60 ms GPU 计算、30 ms 通信。若三段完全串行,总时间 110 ms;若通信中的 20 ms 与计算重叠,总时间可能变为 90 ms。不能把时间线里每个条目的时长简单相加,因为并行区间会重复计算。
同理,缩短已经被别的工作完全覆盖的操作,可能不改变总时长。优化优先级应该由暴露在关键路径上的时间决定,而不是只看某类事件的累计占比。
异步执行会让普通计时器说谎
GPU 调用可能只把工作放进队列就返回。若用 CPU 计时器包住一次异步调用而不等待完成,测到的可能主要是提交时间。设备同步或设备事件可以获得更明确的测量,但同步本身又可能改变原有重叠,因此微基准与真实链路都要看。
第一次执行还可能包含编译、内存分配、库初始化和缓存填充。报告稳态时先预热;研究冷启动时则应该保留这些成本。两者都合理,关键是不要混在同一个平均值里却不说明。
从症状到下一步实验
如果 GPU 前有长空白,检查 CPU 数据读取、tokenization、调度或同步;如果 collective 前各 rank 到达时间不一致,检查负载不均、数据长度和慢设备;如果一个 kernel 带宽接近上限但算力很低,考虑减少搬运或提高复用,而不只追求更多算术单元。
这些是待验证假设,不是看到某个形状就能自动得出的结论。每次只改变一个关键变量,保存前后 trace 和相同工作负载,防止把随机波动当成收益。
一个实用的优化记录模板
记录问题、基线、假设、修改、正确性检查、性能变化和副作用。例如“长 prefill 导致 decode 间隔 p95 上升;假设调度干扰;改变 chunk 大小;检查答案一致性;观察 TTFT 和 ITL 是否一升一降”。这比只记录“快了 20%”更有价值。
Profiler 自身也有采样与收集开销,细粒度分析结果需要用较低侵入性的基准复核。不要将带 profiler 的耗时直接与未采集的基线比较。下方 Notebook 用重复 CPU 计时展示波动;真正的 Nsight/XProf 实验需要相应硬件与软件环境,并未由网页模拟。
先问 GPU 为什么没在工作
Nsight Systems 适合看 CPU、CUDA、通信与跨线程时间线;Nsight Compute 深入单个 kernel 的指标;XProf 提供 accelerator 性能分析与 trace 等视图,尤其适合 XLA/JAX/TPU 工作流。三个工具关注的层次不同,不能一上来就用某个 kernel 的低利用率解释端到端延迟。
先标记一个有代表性的稳态窗口:数据加载、tokenization、CPU dispatch、GEMM、attention、collectives、同步。空白可能是等待数据、Python 开销、编译、同步或网络,不一定是设备算力不足。
正确计时比调参更早
GPU 操作通常异步提交,Python 调用返回时不代表 kernel 已结束。使用 CUDA events 或同步后计 wall time,warm-up 排除首次编译、初始化与缓存冷启动。CPU 则不要调用 CUDA 同步。Notebook 的 benchmark 根据设备选择正确计时,并保存分位数与环境。
# 在具备 CUDA / Nsight 的环境运行;先准备自己的 bench.py。
nsys profile --trace=cuda,nvtx,osrt -o baseline python bench.py
ncu --set basic --target-processes all python bench.py
Profiler 会增加开销,尤其详细 kernel 指标采集可能 replay。采样窗口与正常 benchmark 应分开,不能把被 profile 的时间直接当用户延迟。
从观察到可反驳的假设
如果时间线显示每个 decode step 之间有 CPU 空洞,先尝试减少 Python dispatch 或采用兼容的 graph 路径;如果 NCCL 在末尾形成长尾,检查 bucket、overlap 和慢 rank;如果 HBM 接近有效带宽而算力低,研究复用、精度与 cache 流量。每次只改一个主要因素,再复测端到端质量和延迟。
TPU/JAX 要注意首次 compilation、异步 dispatch,以及 block_until_ready() 的时机。XProf 中的 HLO/算子与框架层名称不总是一一对应,需要把编译后的 fusion 与源操作联系起来。
自测
问题: 开启详细 profiler 后模型慢了 5 倍,是回归吗?
展开答案
不能直接判断。先排除采集开销、kernel replay 与同步改变。用无 profiler 的稳定 benchmark 确认真实性能,再用 trace 解释原因。本次真实运行结果
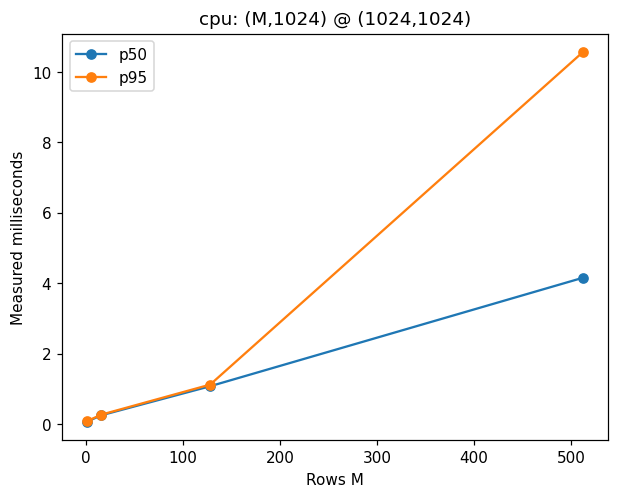
编写时 CPU 实测 matmul 时间,20 次测量的 p50/p95;不是 GPU 或 TPU 基准。
原始资料与继续阅读
资料核对:2026-09-10。教学示例不代表生产基准;框架 API 和模型支持请以所链接版本为准。