从零开始的完整讲解
先问模型的任务,再问它输出了什么
同样叫“模型输出”,不同任务的含义完全不同。生成模型输出词表 logits,用于预测下一个 token;embedding 模型输出向量,用于比较或检索;分类模型输出类别分数。把 embedding 的第 0 维当作“正面情绪概率”,或者把语言模型 hidden state 直接当作经过检索训练的句向量,都缺少必要依据。
本页保留两个互补实验:浏览器里的 MiniLM 加载真实预训练权重,展示 token、mask、句向量和余弦相似度;完整 PyTorch Notebook 使用 DistilGPT2 检查生成模型的内部张量。它们是两个不同模型,不能把一个的 hidden size、词表或 attention 图套到另一个上。
按一次数据流检查四种张量
输入 input_ids 常为 [B,T] 的整数,attention_mask 描述哪些位置有效。Embedding lookup 后得到 [B,T,d] 的浮点表示。每层上下文处理仍常保持这个形状。生成模型再经 LM head 得到 [B,T,V],其中 V 是词表大小。
若 B=1,T=6,d=768,V=50257,hidden state 有 4,608 个元素,而 logits 有 301,542 个元素。两者不是同一个“输出向量”。完整 attention 若被请求返回,通常还带 head 轴,例如 [1,12,6,6]。生产中返回所有层所有头的 attention 会占额外内存,有些优化内核也不会直接物化它。
句向量为什么需要 pooling
文本每个位置都有向量,但检索常需要整句一个向量。Masked mean pooling 将有效位置的向量相加,再除以有效位置数量。如果把 padding 也纳入平均,两句内容相同但 batch 补齐长度不同,结果可能受到影响。
对句向量再做 L2 normalization,使其长度为 1。此时向量点积等于余弦相似度。以 [3,4] 为例,长度为 5,归一化得到 [0.6,0.8]。归一化不等于每维都变成概率:分量可以为负,分量之和不必为 1。
import math
u, v = [3,4], [4,3]
def norm(x): return math.sqrt(sum(a*a for a in x))
cosine = sum(a*b for a,b in zip(u,v))/(norm(u)*norm(v))
print(cosine)  # 0.96
为什么相似度高不能直接解释为“答案正确”
Embedding 接近说明模型所学习的相似性标准下两段文本靠近。否定句、实体替换、数字差异可能仍然语义接近:“可以退款”和“不可以退款”谈论相同主题,却给出相反操作。相似度不是经过业务校准的概率,更不是事实验证器。
在真实 MiniLM 实验中先试两句相近英文,再只替换日期、金额或否定词。记录相似度变化,思考检索阶段是否仍需要重排和答案验证。该 checkpoint 主要面向英文句向量,不应把它的中文表现代表所有多语言模型。
代码细节会改变你以为正在观察的东西
调用 tokenizer 时的最大长度必须真正作用于送入 forward 的张量,而不是只用于展示。否则页面上显示 128 个 token,模型却可能读了另一份输入。本页的模型实验让同一份编码结果同时用于展示和实际 forward,避免这个接口错位。
还要确认 pooling 排除了哪些位置,是否包含特殊 token,输出来自最后一层还是中间层。对比两种向量方法时保持这些条件一致。把模型切为 eval、固定输入与软件版本,有助于区分实现差异与模型差异。
实验记录应包含失败,而不只是成功截图
首次运行需要下载浏览器推理库与模型权重,完成后前向在本机执行。若网络或设备内存不足,页面会报告失败,不会用预先准备的向量替代。标准 Python Notebook 则用于亲自训练小型模型、逐格观察张量。完整 PyTorch 标签展示已执行的 CPU 输出,并提供完整环境的运行入口;浏览器内核不能直接安装普通 CUDA PyTorch。
先决定要观察什么
“加载模型”不是一个按钮就解释完的概念。本章拆成三层:tokenizer 把输入变成什么;forward 返回哪些张量;任务后处理怎样把张量变成有意义的结果。浏览器使用 Xenova/all-MiniLM-L6-v2,这是适合轻量语义相似度实验的 encoder。它不会自回归聊天。
下方按钮下载实际 ONNX 权重,在浏览器 CPU/WASM 中运行。不会用预置相似度替代失败结果。初次需要下载运行库和模型;访问失败或超时会明确显示错误。模型主要面向英文,中文界面不意味着模型具有同等中文检索能力。
从 token 表示到句子向量
模型先给出每个 token 的表示,再做带 mask 的 mean pooling,最后 L2 归一化。设有效 token 指示为 m,句向量为 ,然后除以 。归一化向量的点积等于余弦相似度,取值范围是 -1 到 1,不是置信概率。
实验展示真实 token IDs、padding mask、输出 [2,384] 和前 32 个维度。单个 embedding 维度通常没有稳定可命名的语义;条形图用于观察数值,不要称作模型“关注哪里”。
更深入:打开 Notebook
配套 Notebook 加载 distilgpt2 的真实权重,输出 [B,T,V] logits、各层 hidden states 与 [B,H,T,T] attention,并验证缓存和完整前向的一致性。使用 eager attention 以显式返回权重;高性能 attention backend 不一定返回相同可观察对象。
from transformers import AutoTokenizer, AutoModelForCausalLM
tok = AutoTokenizer.from_pretrained('distilgpt2')
model = AutoModelForCausalLM.from_pretrained(
    'distilgpt2', attn_implementation='eager').eval()
inputs = tok('The cat is', return_tensors='pt')
# 完整 Notebook 包含 no_grad、可视化和缓存一致性检查。
三个值得真的尝试的反例
比较 “The cat is sleeping” 与近义改写;再把否定词加入第二句;最后换成领域术语或中文。词汇重叠高可能导致相似度仍然高,即使逻辑含义相反。把输入拉长超过 128 tokens,检查截断是否删除关键信息。实验记录应同时保存输入、有效长度与模型版本。
问题: 两个句向量余弦为 0.9,是否表示它们有 90% 概率互相蕴含?
展开答案
不是。余弦衡量表示空间的几何接近程度。逻辑蕴含需要相应任务和验证集,不能从未经校准的相似度推导概率。本次真实运行结果
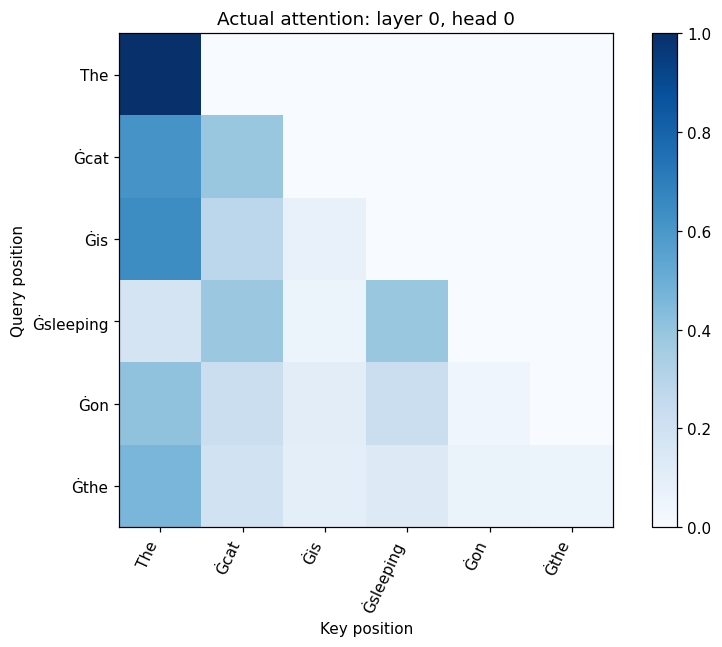
实际 DistilGPT2 前向得到的第 0 层第 0 个 attention head。上三角为零,因果遮罩有效。
原始资料与继续阅读
资料核对:2026-09-10。教学示例不代表生产基准;框架 API 和模型支持请以所链接版本为准。
PRETRAINED MODEL · MiniLM-L6 · WASM / CPU
加载真实模型,看见 token 和 embedding
点击后从 Hugging Face 下载量化模型(约 23 MB 权重,另需运行库)。文本在本地浏览器计算,不发送给推理服务。需要能访问 Hugging Face 与 jsDelivr。这个模型主要面向英文,不是聊天大模型;最多处理 128 tokens。